Schwierig für KI
Komplexität kapseln
Fortgeschrittene Diagramme, räumliche Layouts und gekoppelte Interaktionen werden zu getesteten Komponenten mit wenigen aussagekräftigen Parametern.
Wenige Parameter → anspruchsvolles, stabiles ErgebnisKI kombiniert Komponenten passend zu deinem Bedarf. Wir prüfen echte Aufgaben, um Darstellung und spätere Änderungen zu verbessern.
Ansätze im Vergleich
Direkte Generierung ist schnell, doch das Ergebnis hängt vom Modell ab. Vorlagen sind stabiler, begrenzen aber die Möglichkeiten. OWL Compose lässt den Agenten frei kombinieren, zuverlässig fertigstellen und später weiterarbeiten.
Das Ergebnis kommt schnell, seine Qualität hängt aber jedes Mal vom Modell ab.
Der Einstieg ist leicht und das Ergebnis stabil, doch Inhalt und Layout bleiben an die Vorlage gebunden.
Layouts, Diagramme und Gestaltung frei kombinieren und dasselbe Werk weiter bearbeiten und veröffentlichen.
Direkte Generierung führt bei Tempo und Freiheit, Vorlagen bei Stabilität; OWL Compose ist über den gesamten Ablauf am ausgewogensten.
Echte Werke
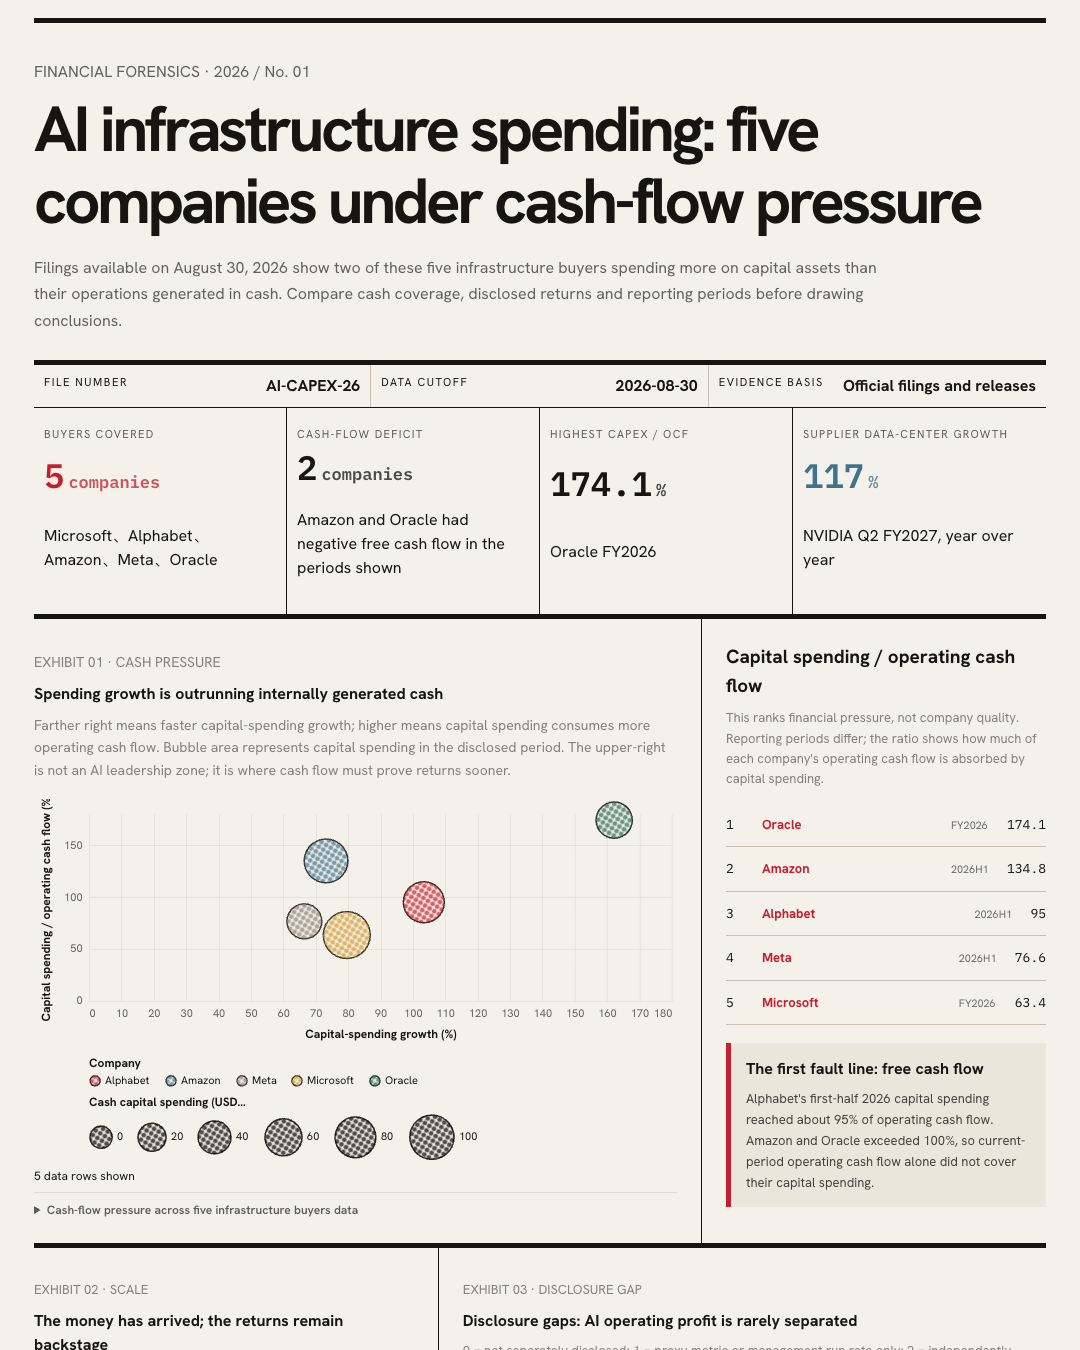
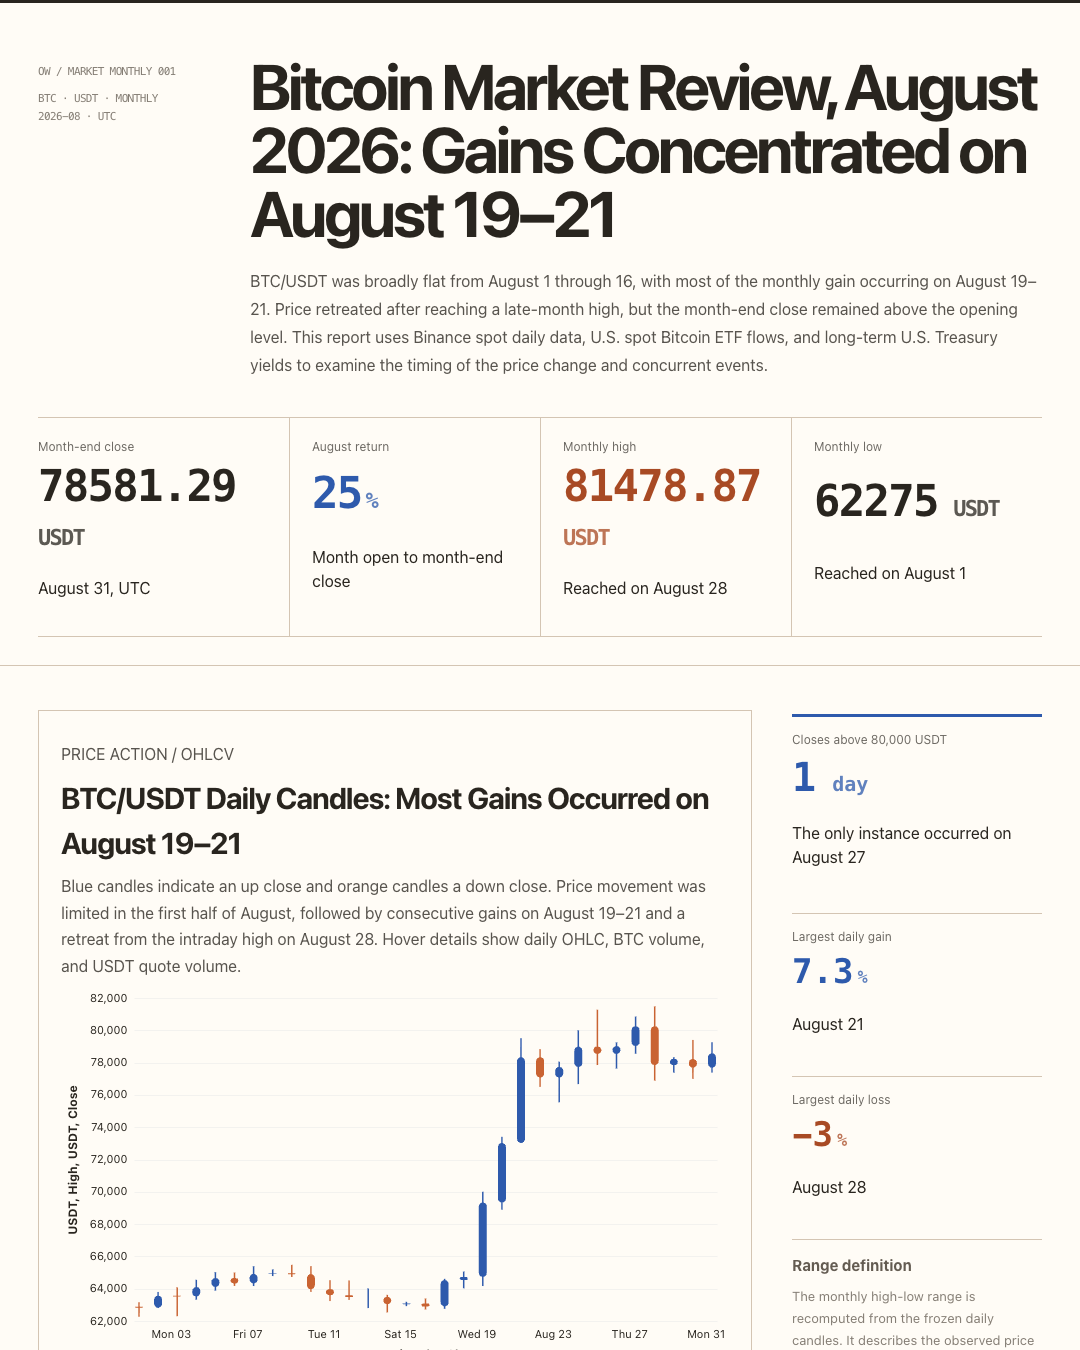
Öffne ein veröffentlichtes Beispiel und erkunde Inhalte und Diagramme.
Fortlaufende Tests
Wir testen OWL Compose wiederholt mit Basismodellen nahe der Preis-Leistungs-Grenze. Aufgaben und Konfiguration bleiben gleich; nach Modellupdates testen wir neu und passen das System an.
Adaptive Abstraktion
Die Autorenschicht ist nicht einheitlich grob oder fein. Wir setzen jede Grenze danach, was Basismodelle zuverlässig erzeugen können.
Fortgeschrittene Diagramme, räumliche Layouts und gekoppelte Interaktionen werden zu getesteten Komponenten mit wenigen aussagekräftigen Parametern.
Wenige Parameter → anspruchsvolles, stabiles ErgebnisWo Modelle zuverlässig komponieren, teilen wir die Fähigkeit in feinere Primitive, statt sie in einer Vorlage einzuschließen.
Feine Syntax → mehr gestalterische FreiheitMit denselben Basismodellen und festen Aufgaben ablatieren wir jede Schicht regelmäßig. Eine Grenze bleibt nur, wenn die Evidenz ihren Nutzen zeigt.
15 Konfigurationen · AA v4.2 · USD / Aufgabe
Farbige Punkte bilden die obere Hüllkurve auf einer logarithmischen Kostenachse. Grau: günstigere, mindestens gleich gute Alternative. Hohl: unter der Hüllkurve. Belegte Stichprobe, keine vollständige Rangliste. Kandidaten benötigen eigene Qualitätstests; unbekannte Aufgabenkosten sind ausgeschlossen.
| Model | USD | AA v4.2 | Preis–Leistungs-Grenze |
|---|---|---|---|
| GPT-5.6 Luna (max) | 0.10 | 43 | Referenzkandidat |
| GLM-5.3-Flash | 0.18 | 46 | Referenzkandidat |
| DeepSeek V4 Flash 0731 (max) | 0.14 | 41 | Dominiert |
| MiniMax-M3 | 0.23 | 36 | Dominiert |
| DeepSeek V4 Pro 0813 (max) | 0.33 | 42 | Dominiert |
| Gemini 3.1 Pro Preview | 0.34 | 37 | Dominiert |
| Gemini 3.7 Flash (high) | 0.55 | 45 | Dominiert |
| GPT-5.6 Terra (max) | 0.81 | 47 | Unter der Hüllkurve |
| Muse Spark 1.3 (max) | 0.96 | 53 | Referenzkandidat |
| GPT-5.6 Sol (max) | 1.25 | 51 | Dominiert |
| GLM-5.3 (max) | 1.26 | 49 | Dominiert |
| Kimi K3 (max) | 1.58 | 50 | Dominiert |
| GPT-6 Astra (max) | 2.57 | 55 | Unter der Hüllkurve |
| Claude Opus 5 (max) | 4.21 | 54 | Dominiert |
| Claude Fable 5.1 (max, fallback) | 6.12 | 57 | Referenzkandidat |